
先学函数来规范代码,后学数组接触指针
数组
相同类型元素的一个集合。在内存中是段连续的空间
可以理解为代标号的 从0开始 的停车位
一维数组
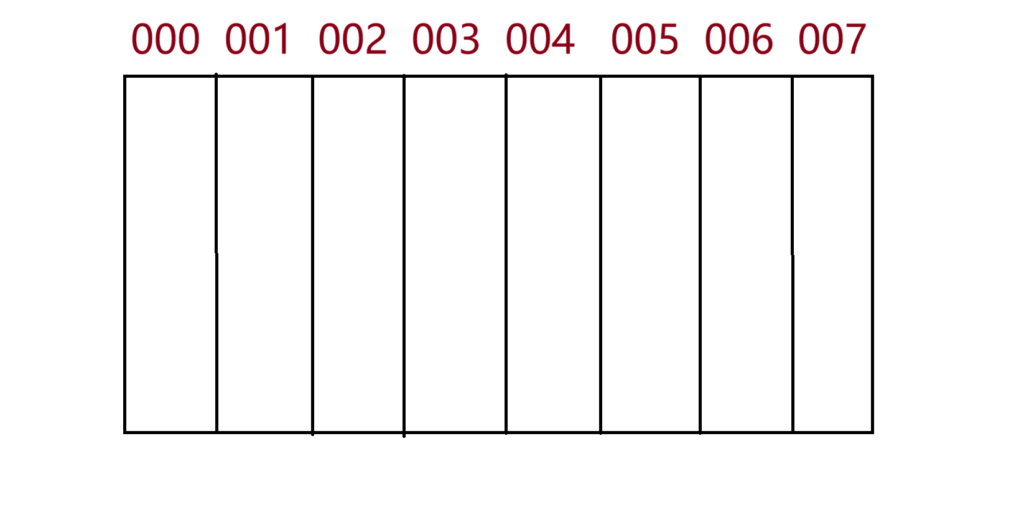
创建数组
数据类型 变量名[数值]
int icu[5]//从0开始,一共有5个位置的整数型数组
初始化
- 全面初始化
数据类型 变量名[数值]
int icu[5]={1,2,3,4,5}//从0开始,一共有5个位置的整数型数组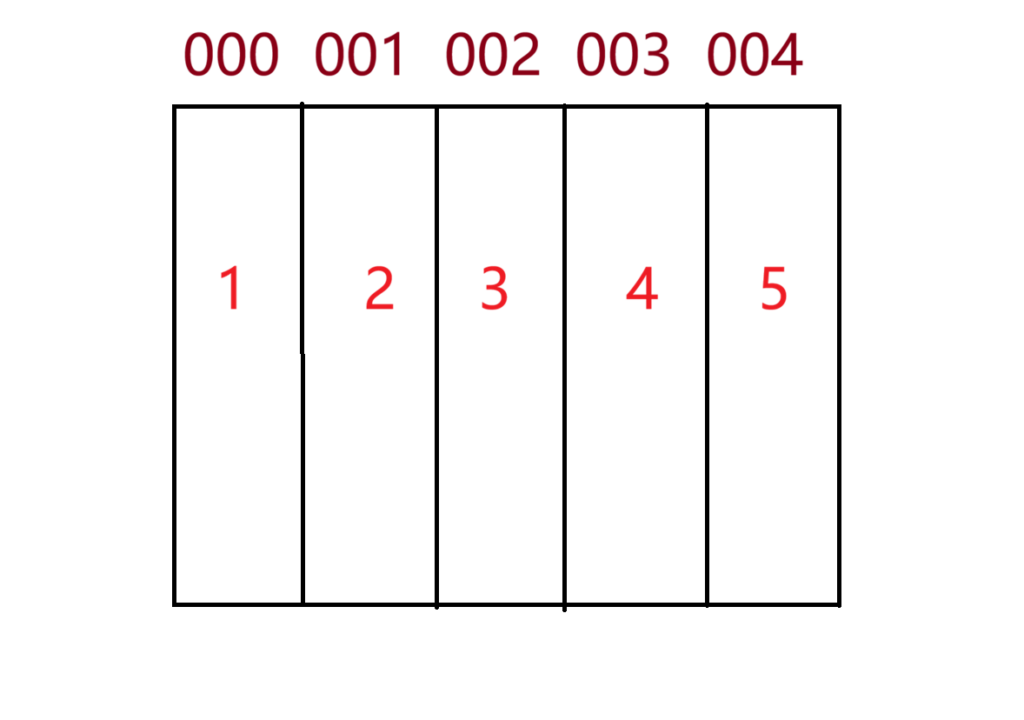
- 局部初始化
数据类型 变量名[数值]
int icu[5]={1,2}//只有前2个有数字其他补0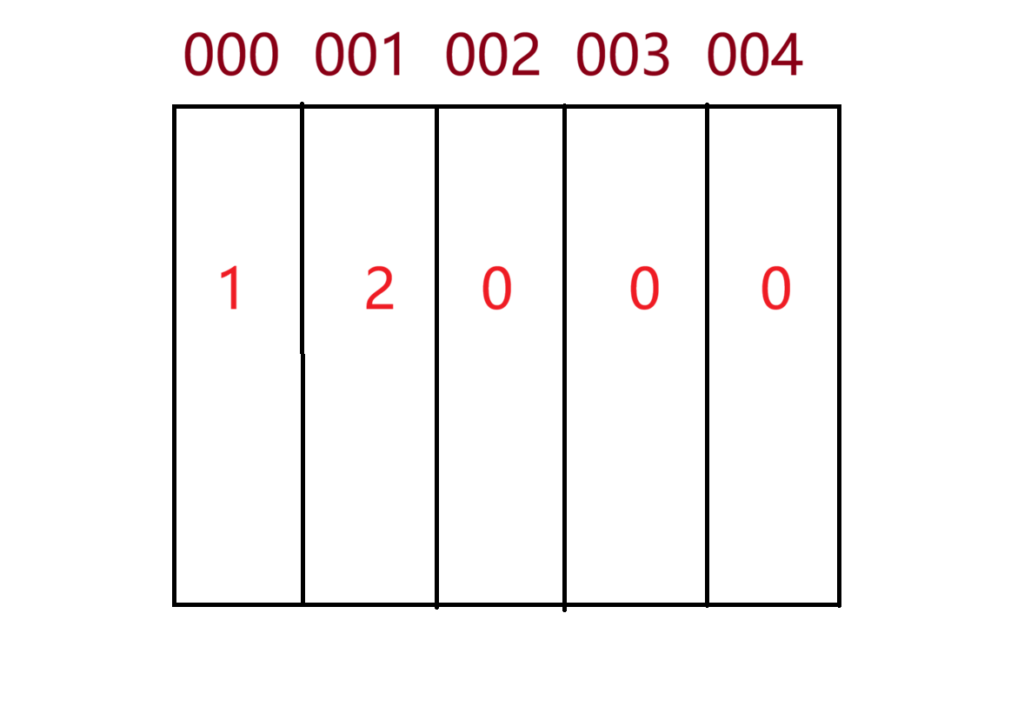
- 省略初始化
数据类型 变量名[数值]
int icu[]={1,2}//会自动根据元素个数来推导长度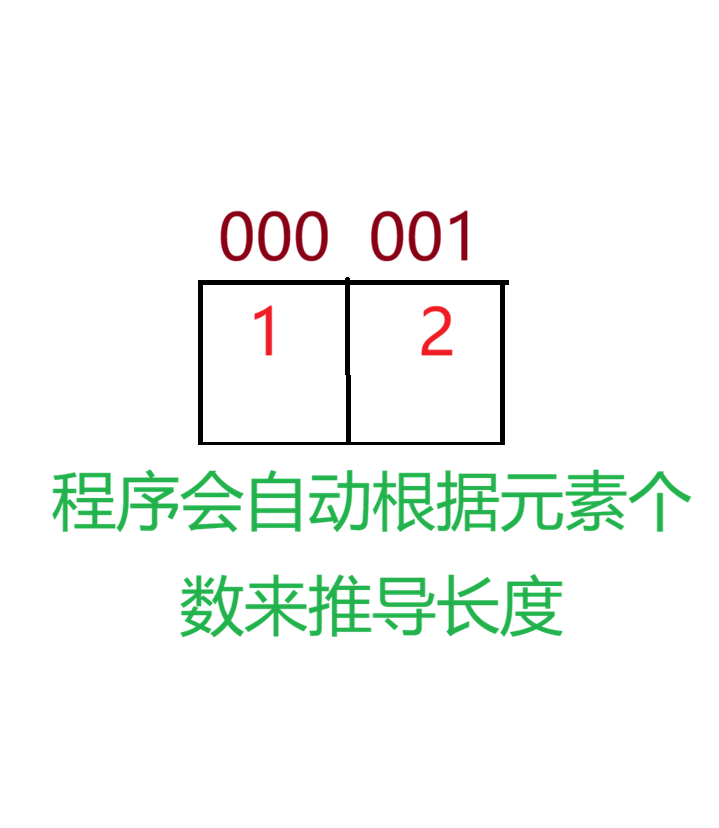
遍历数组
数组中的每个元素都有自己的下标,可以使用 for
循环依次访问数组中的所有元素。
例如:
#include <stdio.h>

int main()
{
    int a[5] = {1, 2, 3, 4, 5};

    for (int i = 0; i < 5; i++)
    {
        printf("%d\n", a[i]);
    }

    return 0;
}
运行后:
1
2
3
4
5
这里的 i 就是数组的下标:
i = 0 → a[0]
i = 1 → a[1]
i = 2 → a[2]
i = 3 → a[3]
i = 4 → a[4]
所以:
for (int i = 0; i < 5; i++)就可以让 i 从 0 变化到
4,刚好访问数组中的所有元素。
修改数组中的所有元素
因为 a[i]
可以作为一个变量使用,所以不仅可以读取元素,也可以修改元素。
例如,把数组中的每个元素都乘以 2:
#include <stdio.h>

int main()
{
    int a[5] = {1, 2, 3, 4, 5};

    for (int i = 0; i < 5; i++)
    {
        a[i] = a[i] * 2;
    }

    for (int i = 0; i < 5; i++)
    {
        printf("%d\n", a[i]);
    }

    return 0;
}
结果:
2
4
6
8
10
可以理解为:
原数组:

a[0] = 1
a[1] = 2
a[2] = 3
a[3] = 4
a[4] = 5

        ↓ for循环

修改:

a[0] = 1 × 2
a[1] = 2 × 2
a[2] = 3 × 2
a[3] = 4 × 2
a[4] = 5 × 2

        ↓

新数组:

2  4  6  8  10
总结:
使用 a[i] 可以访问数组中的第 i 个元素。
a[i]       // 读取元素
a[i] = 10; // 修改元素
配合 for
循环,就可以依次读取或修改数组中的所有元素。
数组下标从 0 开始,所以遍历长度为 5 的数组时,条件应该是 i < 5,而不是 i <= 5。
使用 %p
查看数组元素的地址
前面说过,数组在内存中是一段 连续的空间 。
可以使用 printf 的 %p
来查看变量的地址。
#include <stdio.h>

int main()
{
    int a[5] = {1, 2, 3, 4, 5};

    for (int i = 0; i < 5; i++)
    {
        printf("a[%d] 的地址:%p\n", i, (void *)&a[i]);
    }

    return 0;
}
运行后可能得到:
a[0] 的地址:0x7ffd12345020
a[1] 的地址:0x7ffd12345024
a[2] 的地址:0x7ffd12345028
a[3] 的地址:0x7ffd1234502c
a[4] 的地址:0x7ffd12345030
可以发现,每个元素的地址都是连续的。
a[0] → 0x...20
a[1] → 0x...24
a[2] → 0x...28
a[3] → 0x...2c
a[4] → 0x...30
          ↑
       每次 +4
这是因为这里的数组元素类型是 int,而在常见的 C 环境中
int 占 4 字节。
因此:
a[0] 占用 4 字节
a[1] 占用 4 字节
a[2] 占用 4 字节
...
所以数组的元素会一个接一个地排列在连续的内存空间中。
%p 是什么?
%p 是 printf
用来输出指针(地址)的格式说明符。
例如:
int a = 10;

printf("%p\n", (void *)&a);
其中:
&a表示获取变量 a 的地址。
因此:
printf("%p\n", (void *)&a);就是把 a 的地址打印出来。
为什么使用 (void *)?
%p 对应的是 void *
类型的指针,所以写成:
printf("%p\n", (void *)&a[i]);可以明确地将地址转换为 void *。
注意:
每次运行程序时,数组的具体地址可能不同,这是正常现象。我们主要观察的是同一个数组中各元素地址之间的关系。
因此,通过 %p 可以直观看到:
数组的元素在内存中是连续存放的。
sizeof
sizeof
可以用来计算一个变量或数据类型所占用的字节数。
例如:
#include <stdio.h>

int main()
{
    int a = 10;

    printf("%zu\n", sizeof(a));

    return 0;
}
如果当前环境中的 int 占 4 个字节,结果就是:
4sizeof 计算数组大小
sizeof 也可以用来计算整个数组占用的字节数。
#include <stdio.h>

int main()
{
    int a[5] = {1, 2, 3, 4, 5};

    printf("数组大小:%zu 字节\n", sizeof(a));

    return 0;
}
如果一个 int 占 4 字节,那么:
5 个元素 × 4 字节 = 20 字节所以:
sizeof(a) = 20但是我们通常更想知道:
数组里面有多少个元素?
可以使用:
sizeof(a) / sizeof(a[0])例如:
#include <stdio.h>

int main()
{
    int a[5] = {1, 2, 3, 4, 5};

    int length = sizeof(a) / sizeof(a[0]);

    printf("数组有 %d 个元素\n", length);

    return 0;
}
结果:
数组有 5 个元素原理是:
整个数组大小
÷
一个元素大小
=
元素数量
也就是:
sizeof(a)       → 整个数组的大小
sizeof(a[0])    → 一个元素的大小

sizeof(a) / sizeof(a[0])
        ↓
       元素数量
配合 for 遍历数组
这样就不需要把数组长度直接写死:
#include <stdio.h>

int main()
{
    int a[5] = {1, 2, 3, 4, 5};

    int length = sizeof(a) / sizeof(a[0]);

    for (int i = 0; i < length; i++)
    {
        printf("%d\n", a[i]);
    }

    return 0;
}
如果以后把数组改成:
int a[10] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};length 也会自动变成 10。
记住:
sizeof(a)得到的是数组占用的字节数。
而:
sizeof(a) / sizeof(a[0])得到的是数组的元素数量。
数组越界
前面说过,数组的下标是从 0 开始的。
例如:
int a[5] = {1, 2, 3, 4, 5};它一共有 5 个位置:
下标:    0      1      2      3      4
        ┌────┬────┬────┬────┬────┐
数组:  │  1 │  2 │  3 │  4 │  5 │
        └────┴────┴────┴────┴────┘
所以它的合法下标范围是:
0 ~ 4如果访问:
a[5]就超出了数组的范围。
这就叫做数组越界。
可以把数组想象成一排停车位:
停车位:
  0      1      2      3      4
┌────┬────┬────┬────┬────┐
│ 🚗 │ 🚗 │ 🚗 │ 🚗 │ 🚗 │
└────┴────┴────┴────┴────┘
                              ↑
                           没有 5 号车位
但是 C 语言不会自动阻止你访问这个不存在的位置。
例如:
#include <stdio.h>

int main()
{
    int a[5] = {1, 2, 3, 4, 5};

    printf("%d\n", a[5]);

    return 0;
}
a[5] 已经超出了数组范围。
注意:
数组越界属于 C 语言中的未定义行为。
程序可能:
- 输出一个奇怪的数字
- 看起来正常运行
- 修改其他数据
- 甚至直接崩溃
所以在使用数组时,一定要保证下标没有超出范围。
例如:
for (int i = 0; i < 5; i++)
{
    printf("%d\n", a[i]);
}
这里使用 < 5 而不是
<= 5,就是为了保证 i 始终处于:
0 ~ 4也就是数组合法的下标范围。
记住:
数组长度为
n时,下标范围是0 ~ n-1。
二维数组
一维数组可以理解为一排连续的元素。
二维数组则可以理解为由多个一维数组组成的数组。
例如:
c id="f6s0x4" int a[2][3];
表示有 2 行、3 列:
text id="1k9f7r" 列 0 1 2 ┌───┬───┬───┐ 行 0 │ │ │ │ ├───┼───┼───┤ 行 1 │ │ │ │ └───┴───┴───┘
所以一共有:
text id="4xjz9c" 2 × 3 = 6
个元素。
访问二维数组中的元素需要两个下标:
```c id=“2clz0c” a[0][0] a[0][1] a[0][2]
a[1][0] a[1][1] a[1][2]
第一个下标表示**行**,第二个下标表示**列**。

例如:

```c id="h0z5iy"
int a[2][3] =
{
    {1, 2, 3},
    {4, 5, 6}
};
可以理解为:
text id="a7bq2v" 列 0 1 2 ┌──┬──┬──┐ 0 │1 │2 │3 │ ├──┼──┼──┤ 1 │4 │5 │6 │ └──┴──┴──┘
例如:
c id="q4mb4u" printf("%d", a[1][2]);
访问的是:
text id="v9a5dw" 第 1 行 ↓ 4 5 6 ↑ 第 2 列
所以结果为:
text id="z9pv7w" 6
使用 for 遍历二维数组
因为二维数组有行和列,所以通常使用两个
for 循环。
```c id=“g8wq5p” #include <stdio.h>
int main() { int a[2][3] = { {1, 2, 3}, {4, 5, 6} };
for (int i = 0; i < 2; i++)
{
    for (int j = 0; j < 3; j++)
    {
        printf("%d ", a[i][j]);
    }

    printf("\n");
}

return 0;
}
运行结果:

```text id="a3xqj2"
1 2 3
4 5 6
这里:
c id="1c5y6x" i
表示行。
而:
c id="t3m5p8" j
表示列。
所以:
c id="c9s2rm" a[i][j]
就是:
第
i行、第j列的元素。
可以把它理解成:
text id="2n9x5k" for i → 一行一行地走 for j → 一列一列地走
这就是二维数组最基本的遍历方式。
二维数组初始化
二维数组可以按照行进行初始化:
int a[2][3] =
{
    {1, 2, 3},
    {4, 5, 6}
};
也可以进行部分初始化:
int a[2][3] =
{
    {1, 2},
    {4}
};
结果:
1 2 0
4 0 0
没有提供初始值的位置会自动初始化为 0。
省略二维数组的行数
二维数组初始化时,可以省略第一维的长度。
例如:
int a[][3] =
{
    {1, 2, 3},
    {4, 5, 6}
};
编译器可以根据初始化数据推导出有多少行。
这里可以推导出:
2 行所以相当于:
int a[2][3] =
{
    {1, 2, 3},
    {4, 5, 6}
};
但是列数不能这样省略:
int a[][] = ...这是不正确的写法。
修改二维数组
二维数组中的元素同样可以直接修改。
例如:
int a[2][3] =
{
    {1, 2, 3},
    {4, 5, 6}
};

a[0][0] = 100;
a[1][2] = 600;
修改后:
100  2    3

4    5   600
所以:
a[i][j]既可以读取,也可以修改。
printf("%d", a[i][j]);

a[i][j] = 10;
使用 for 遍历二维数组
因为二维数组有行和列,所以通常使用两个 for 循环。
#include <stdio.h>

int main()
{
    int a[2][3] =
    {
        {1, 2, 3},
        {4, 5, 6}
    };

    for (int i = 0; i < 2; i++)
    {
        for (int j = 0; j < 3; j++)
        {
            printf("%d ", a[i][j]);
        }

        printf("\n");
    }

    return 0;
}
运行结果:
1 2 3
4 5 6
这里:
i表示行。
而:
j表示列。
所以:
a[i][j]就是:
第 i 行、第 j 列的元素。
可以把它理解成:
for i → 一行一行地走

    for j → 一列一列地走
例如:
i = 0

    j = 0 → a[0][0]
    j = 1 → a[0][1]
    j = 2 → a[0][2]


i = 1

    j = 0 → a[1][0]
    j = 1 → a[1][1]
    j = 2 → a[1][2]
这就是二维数组最基本的遍历方式。
二维数组越界
二维数组的每一个维度也都有自己的合法下标范围。
例如:
int a[2][3];行的下标范围:
0 ~ 1列的下标范围:
0 ~ 2所以:
a[0][0]   √

a[1][2]   √

a[2][0]   ×

a[0][3]   ×
例如:
a[2][0]已经超出了行的范围。
而:
a[0][3]已经超出了列的范围。
二维数组同样存在数组越界的问题。
多维数组
二维数组实际上也是一种数组。
C 语言还可以创建三维、四维甚至更高维的数组。
例如三维数组:
int a[2][3][4];可以理解为:
2 个
 ↓
3 × 4 的二维数组
也就是一共有:
2 × 3 × 4 = 24个元素。
访问三维数组需要三个下标:
a[0][0][0]
a[0][0][1]
a[0][1][0]
例如:
#include <stdio.h>

int main()
{
    int a[2][2][3] =
    {
        {
            {1, 2, 3},
            {4, 5, 6}
        },
        {
            {7, 8, 9},
            {10, 11, 12}
        }
    };

    printf("%d\n", a[1][0][2]);

    return 0;
}
结果:
9因为:
a[1]     → 第 2 个二维数组
a[1][0]  → 第 1 行
a[1][0][2] → 第 3 个元素
使用 for 遍历
维度增加后,需要的 for 循环也会增加。
二维数组:
for (int i = 0; i < 2; i++)
{
    for (int j = 0; j < 3; j++)
    {
        printf("%d ", a[i][j]);
    }
}
三维数组:
for (int i = 0; i < 2; i++)
{
    for (int j = 0; j < 2; j++)
    {
        for (int k = 0; k < 3; k++)
        {
            printf("%d ", a[i][j][k]);
        }
    }
}
可以发现:
数组每增加一个维度,访问时就多一个下标,遍历时通常也需要多一层
for循环。
实际编程中,二维数组已经非常常见,更高维数组则根据实际需求使用。
Comments NOTHING